Der perfekte Prompt ist oft eine Illusion. Wer regelmäßig komplexe Workflows baut – etwa zur Automatisierung von zielgruppengerechten Anschreiben –, weiß: KI-Modelle schwanken in ihrer Tagesform. Um in produktiven Systemen konstant hohe Qualität zu garantieren, reicht einfache Textgenerierung nicht mehr aus.
Eine Lösung ist das „LLM-as-a-Judge“-Pattern. In diesem Beitrag zeige ich meinen modularen n8n-Subflow, der LLM-Outputs nicht nur erzeugt, sondern direkt automatisch bewertet.
Die Architektur des Workflows
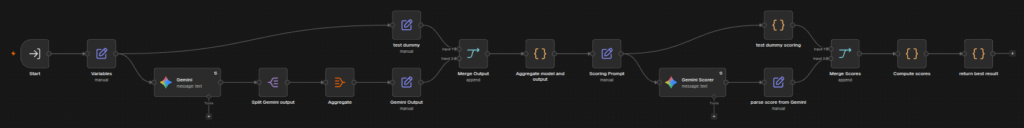
Der Aufbau teilt sich in mehrere Hauptstränge auf, die als intelligenter Filter zwischen Eingabe und finaler Ausgabe fungieren:
- Generierung & Baseline: Der Input (System- und User-Prompt) wird an mehrere LLMs übergeben, in meinem Beispiel Gemini und ein Dummy für Testzwecke.
- Daten-Aggregation: Eine Node bündelt die generierten Ergebnisse sauber in Arrays, um sie für das „Council“ vorzubereiten.
- Das Council (Scoring): Aus den Input-Prompts un den Outputs wird ein neuer System- und User-Prompt für das Scoring gebildet. Diese werden nun wiederun mehrere LLMs übergeben, bei mir wieder Gemini und der Testdummy. Diese bewerten die Outputs strikt auf einer Skala von 0.0 bis 1.0 und geben ein reines JSON-Array zurück.
- Auswertung: Die finale Logik filtert das Ergebnis mit dem höchsten Score heraus und gibt dieses samt der ursprünglichen Prompts an den Haupt-Workflow zurück.
Den Workflow könnt ihr euch jederzeit anpassen, indem ihr LLMs ersetzt oder weitere Zweige für die Generierung und/oder das Scoring ergänzt.
Fazit und Ausblick
Dieser Subflow ist stark modularisiert und lässt sich als Qualitäts-Gatekeeper an jeden bestehenden Prozess andocken.
Viel Spass beim Testen und Weiterbasteln!
Hier der komplette Workflow zum Download: LLM Council.json
Schreibe einen Kommentar